
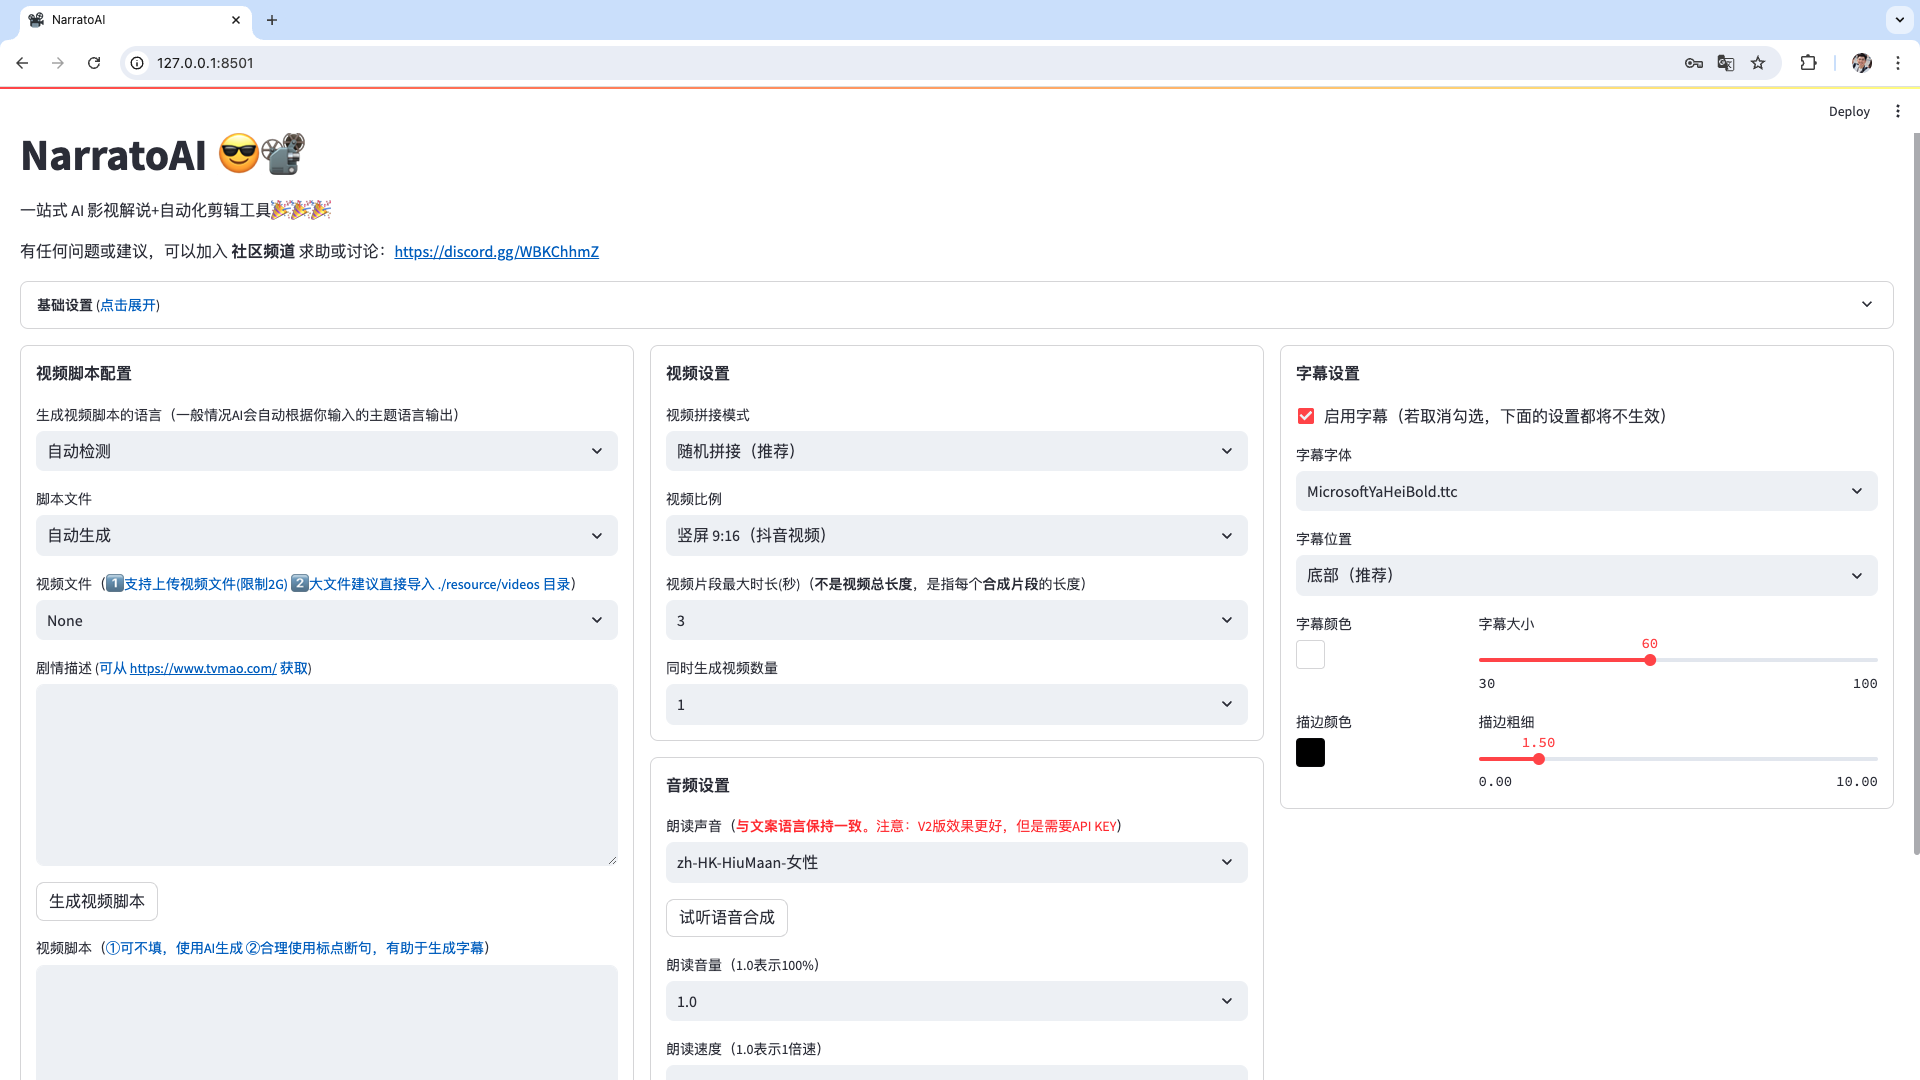
NarratoAI 是 linyqh 用 Python 写的开源影视解说自动化工具,GitHub 上 11,844 星、MIT 协议,把「看片写稿」换成一条流水线:大模型读画面和台词生成解说文案,程序按文案把原片剪成一段段,再合成配音和字幕,最后直接出一个能发的短片。整条流程跑在本地网页界面里,不用注册账号,也不按分钟收费。
做影视解说最磨人的不是创意,是重复劳动。一部两小时的片子,先得看两遍记下高光,再把截图和台词对到时间码,写完稿子还得手动剪十几刀、配一遍音、压一遍字幕。一个熟手一天最多出两三条,新手往往卡在「文案跟画面对不上」这一步就放弃了。NarratoAI 想解决的正是这一段:人只留到最后审片和改稿,前面的粗活全交给模型和 ffmpeg。
参数一览
| 项目仓库 | linyqh/NarratoAI,GitHub 11,844 星 |
| 协议 / 语言 | MIT 协议,Python 3.12 以上 |
| 最新版本 | v0.8.7(2026-07-17) |
| 部署方式 | Windows 整合包、macOS arm64 包、Docker、uv 源码运行 |
| 硬件门槛 | 4 核 CPU、8GB 内存起,显卡非必需 |
| 配音引擎 | IndexTTS、豆包、腾讯云,支持参考音频克隆音色 |
工具特点
- 文案、剪辑、配音、字幕一条链路:从剧情理解到成片输出不用换软件,中途只在预览页调片段时间点。
- 真按画面挑片段:可接 Qwen2-VL 或 TwelveLabs 这类视频理解模型做逐帧分析,避免文案念到第三句、画面还停在片头。
- 短剧混剪单独一套流程:素材一键合并、一键转录、一键清缓存,适合批量做几分钟一集的追剧号。
- 能导出剪映草稿:不想全自动的,把工程导进剪映再手改,比对着成品重剪省事得多。
- 完全免费:作者在仓库首页特意写明,网上有人把它改名打包卖钱,认准 linyqh 名下的原仓库,别为同一份代码付费。
适合人群
- 做影视解说、短剧混剪、纪录片拆条的自媒体账号,尤其是日更压力大的。
- 想批量测试选题的运营:一条流水线跑出三五个版本,再挑数据好的那条精修。
- 有 8GB 内存以上电脑、愿意花半小时装环境的普通用户——不用显卡也能跑,画面理解交给云端多模态模型。
上手四步
- 到仓库下载对应系统的整合包(Windows 选 x64,Mac 必须是 Apple Silicon),完整解压,别单独挪动 runtime、tools 这些子目录。
- Windows 先双击 update-windows.bat 拉最新代码,再双击 start.bat;Mac 先在终端执行 xattr -cr 解除隔离,再依次运行两个 .command 脚本。
- 浏览器打开本机的 8501 端口,在设置里填一个大模型接口(任何 OpenAI 兼容的都行,DeepSeek、硅基流动这类够用),配音引擎按需选本地 IndexTTS 或云端 TTS。
- 导入片子、生成剧情概要、确认解说文案、选剪辑模式出片。第一次建议拿十分钟的短片练手,把每段时长和抽帧密度调到顺手再上长片。
问:NarratoAI 要钱吗?会不会偷偷扣费?
答:软件本身 MIT 协议、完全免费,没有内购也没有时长限制。唯一花钱的是你自己接的大模型和 TTS 接口,按 token 或字符计费,一条十分钟的解说大概几毛钱,用本地 IndexTTS 配音则这部分零成本。
问:没有独立显卡能跑吗?
答:能。官方要求是 4 核 CPU 加 8GB 内存,画面理解走云端模型,剪辑和合成靠 ffmpeg 吃 CPU。十几分钟的片子在中端笔记本上十几分钟能出片,长片会慢一些。
问:Mac 能用吗?
答:可以,但只支持 M 系列芯片的 arm64 版本;Intel 芯片的 Mac 只能走 Docker 或源码本地跑,官方整合包没提供 x86 版。
问:生成的视频能商用、能过平台原创审核吗?
答:软件协议允许商用,但片子里的影视素材版权在片方手里,解说号本身属于二次创作,能不能过审取决于平台规则和你改了多少——纯 AI 拼出来的流水线成品,各平台判定并不一致,重要账号建议人工重写文案、重配解说。
最后更新:2026-11-17
声明:本站所有文章,如无特殊说明或标注,均为本站原创发布。任何个人或组织,在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。
