
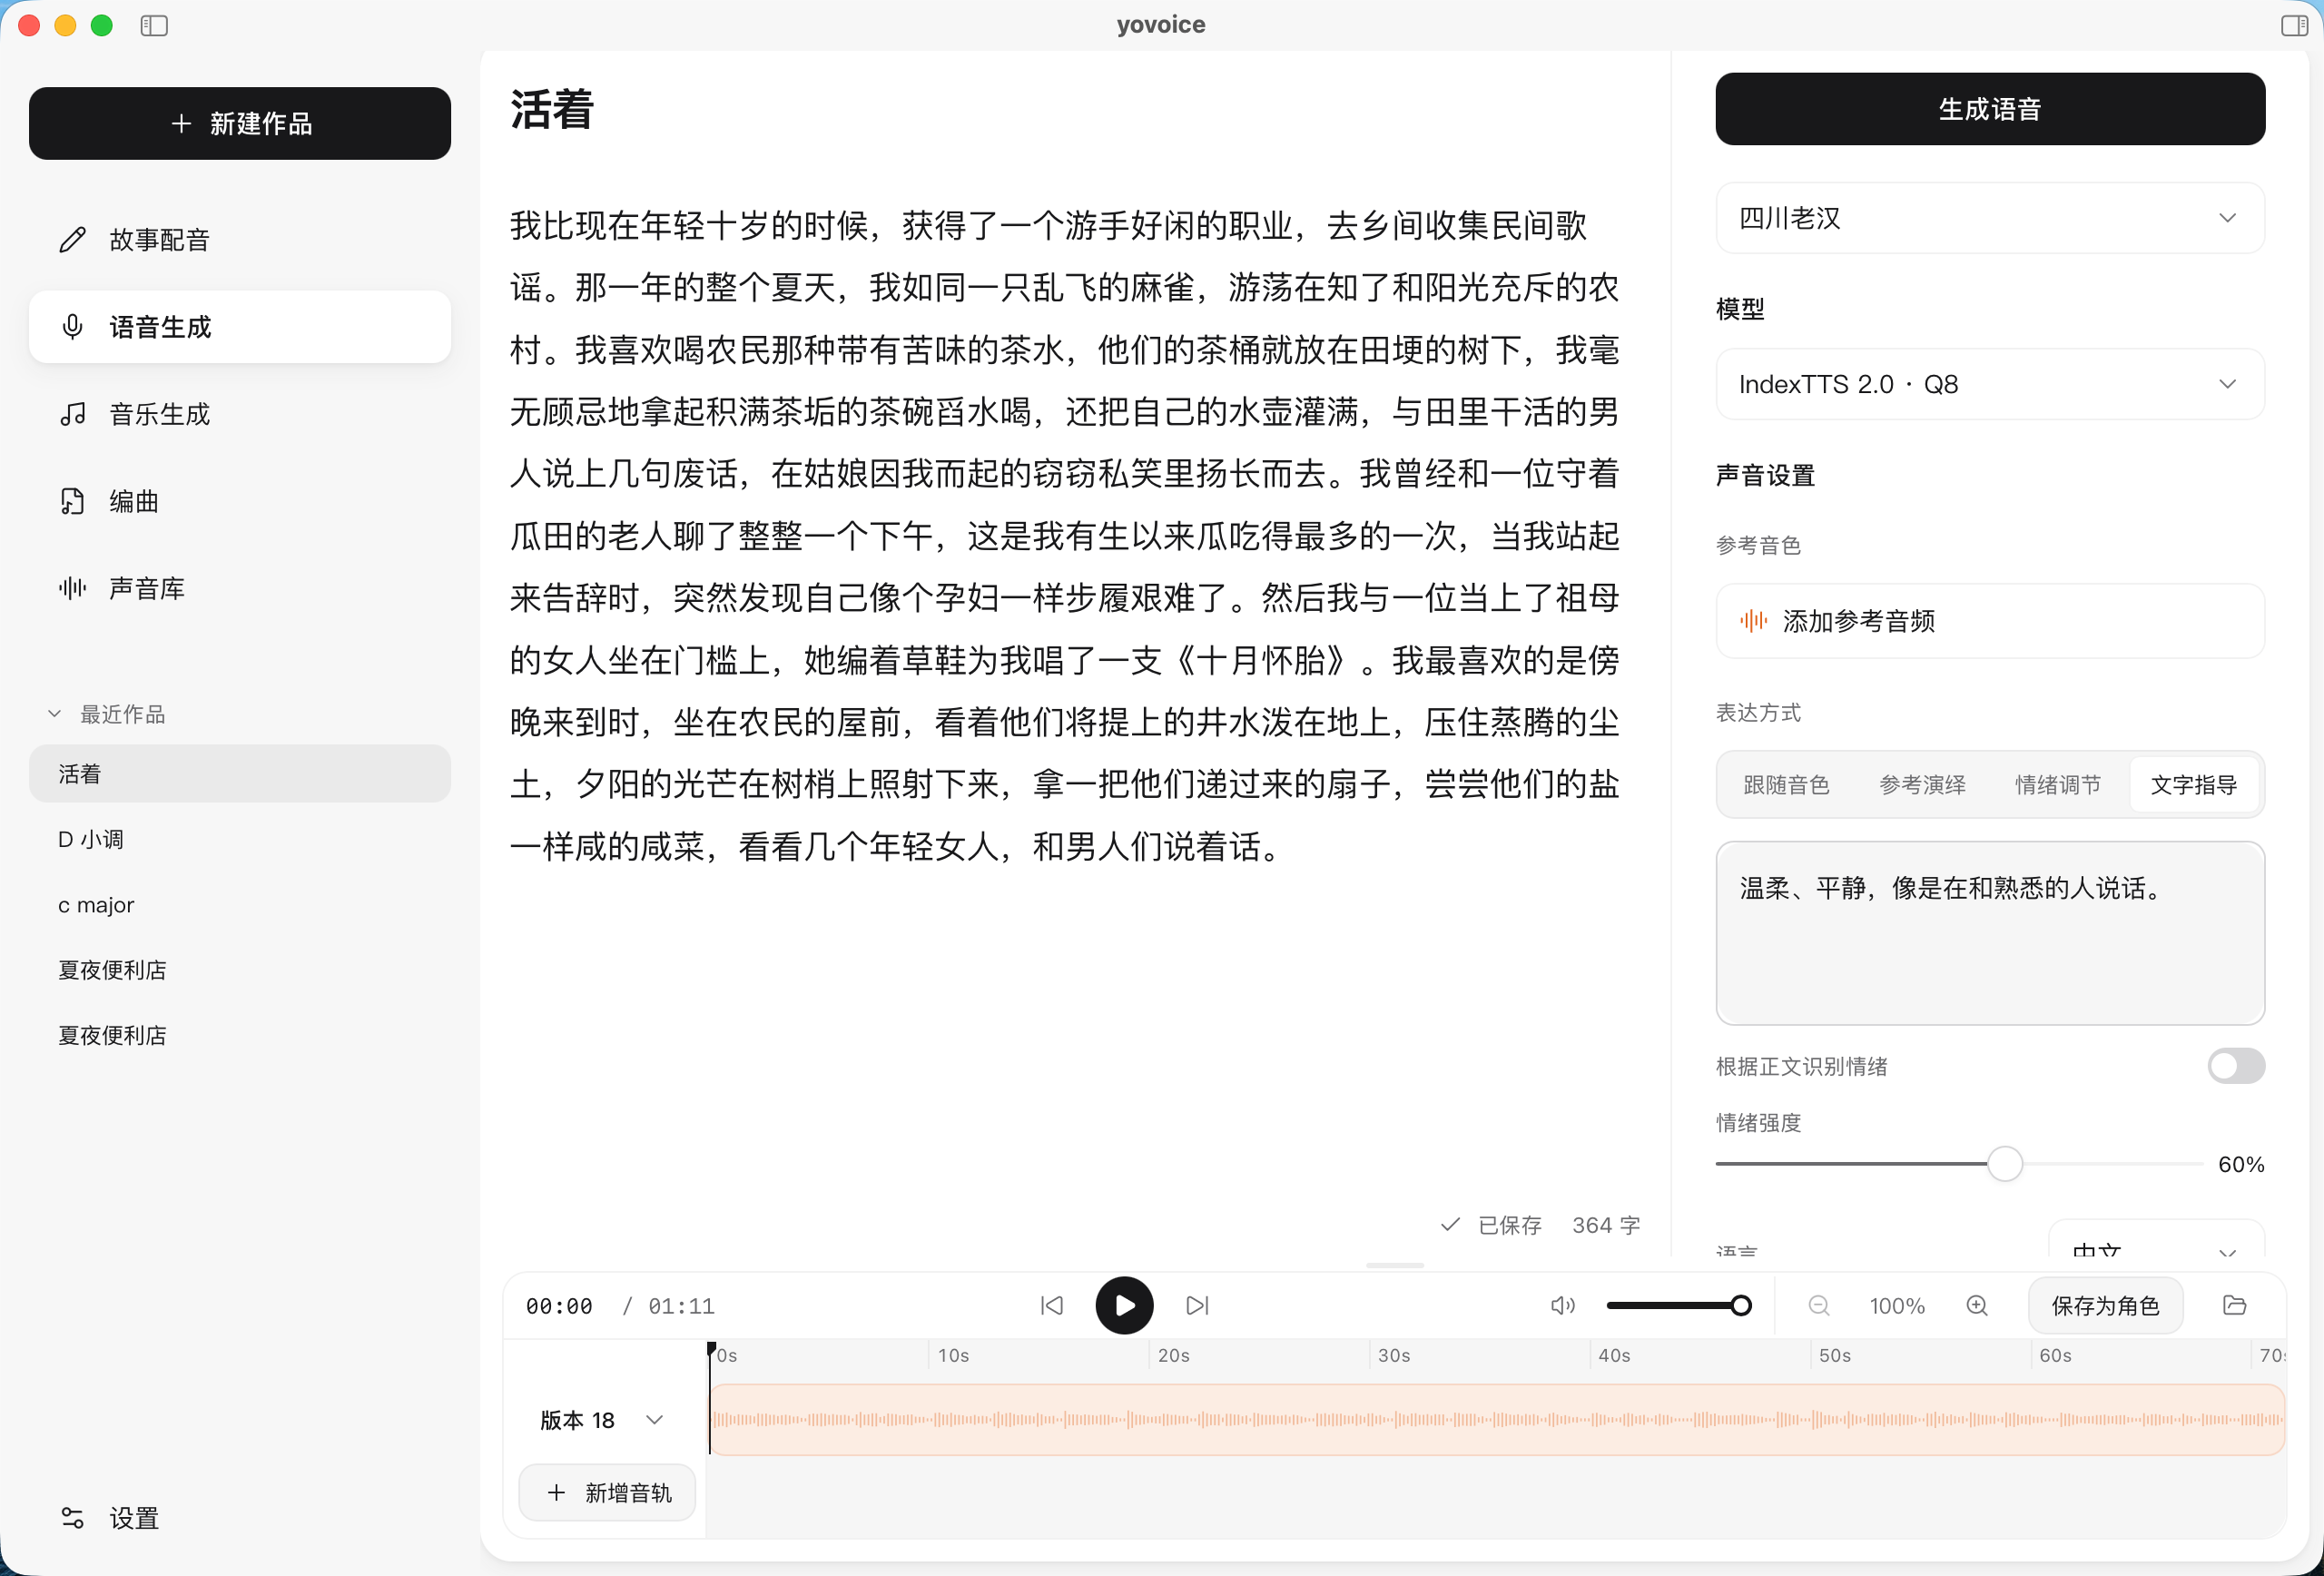
yovoice 是一款开源、本地优先的 AI 音频与音乐创作工作站:语音合成、声音克隆、AI 写歌、MIDI 编曲全在自己的电脑上跑,全程不联网、不按字数计费。它用 TypeScript 配 C++ 推理内核(底层 audio.cpp)写成,GitHub 约 1900 星,Apache-2.0 协议,免费,支持 macOS 14 以上的 Apple 芯片机型、Windows 10/11 和 Linux。
做配音的人大多遇到过同一套麻烦:云配音按字算钱,一条十分钟的口播稿先垫几十块;稿件里有客户名称、未发布的产品信息,传上去心里发虚;订阅到期当天,之前生成的作品全都没法再导出。yovoice 的思路是把整条链路搬回本地——模型下载到自己硬盘,参考音、稿件、成片都在本地,断网照样能出活。
工具特点
- 零 API 费用:模型本地推理,不按字、不按分钟收费,也没有订阅,用多久都不额外花钱。
- 声音克隆与情绪控制:导入或现场录一段参考音频就能复刻音色,情绪、语速和表演细节还能单独调。
- 故事配音:导进纯文本或字幕文件,按行分配角色,逐句生成台词,长篇旁白不用手工切段。
- AI 写歌:写好风格和带段落标记的歌词,直接生成带唱的人声或纯伴奏,播放页歌词跟唱同步。
- 分轨与 MIDI 导出:波形裁剪、多版本并列对比、时间轴滚动,最后导出干净的分轨与 MIDI。
- 原生性能:不用装 Conda 和 PyTorch,Windows 安装包自带 CUDA 12.4/13.3 运行时,macOS 走 Metal,Linux 默认 CPU、可另装 Vulkan。
支持模型一览
| 用途 | 可用模型 |
| 声音克隆 / 情绪 | IndexTTS 2.0、IndexTTS 2.5、Qwen3-TTS Base |
| 音色设计 / 克隆 | VoxCPM2、OmniVoice、Qwen3-TTS VoiceDesign、Breeze TTS 2 |
| 内置音色 | Kokoro-82M、Qwen3-TTS CustomVoice |
| 歌曲与伴奏 | ACE-Step 1.5 Turbo / XL Turbo、YuE2 3B |
| 纯音乐 / 音效 | Stable Audio 3(Small Music / Small SFX / Medium) |
授权要留意:OmniVoice、YuE2 和 Breeze TTS 2 的权重仅限非商业用途;Stable Audio 3 按 Stability AI 社区协议,年收入 100 万美元以下免费。
适合人群
- 做短视频、播客、有声书,长期需要配音又要压成本的自媒体。
- 稿件涉密或不便上云的企业内训、产品演示配音。
- 想试试 AI 音乐、又不想买订阅的独立音乐人和爱好者。
- 愿意在自己机器上跑模型的折腾党,以及用 Cursor、Claude Code 联动 MCP 的开发者。
使用说明
- 从官方发布页挑对应安装包:Apple 芯片选 dmg,Windows 选 setup,NVIDIA 显卡优先选自带 CUDA 运行时的版本。
- 首次打开进入设置,先下一个模型:日常旁白用 Kokoro-82M,体积小、出音快;要克隆音色再下 VoxCPM2 或 IndexTTS。
- 新建项目,按用途选故事配音、语音生成或音乐,粘贴文本或导入字幕文件。
- 选中台词行,指定音色或用参考音频克隆,再调情绪与语速,逐句生成。
- 在时间轴上裁剪、对比多个版本,满意后导出音频;需要后期就再导出分轨和 MIDI。
问:yovoice 收费吗?
答:软件本身免费开源(Apache-2.0),模型在本地运行,不按字数或时长收费,也没有订阅。只有部分模型权重因授权限制不能商用,商业项目请先看模型说明。
问:必须联网才能用吗?
答:生成过程完全离线,只有下载模型、检查更新时需要联网。可选的 AI 助手面板如果接 DeepSeek、OpenAI 这类云端服务才需要网络,密钥保存在本机。
问:没有独立显卡能跑吗?
答:可以,走 CPU 也能出音,只是慢一些。Windows 装了 NVIDIA 显卡建议用自带 CUDA 运行时的安装包;Mac 用 Apple 芯片走 Metal 加速;Linux 默认 CPU,可在设置里另装 Vulkan 运行时。
问:生成的音频能商用吗?
答:软件协议允许商用,但克隆他人音色涉及声音权,务必先拿到授权;模型权重另有条款,OmniVoice、YuE2、Breeze TTS 2 仅限非商业使用。
最后更新:2026-10-29
