
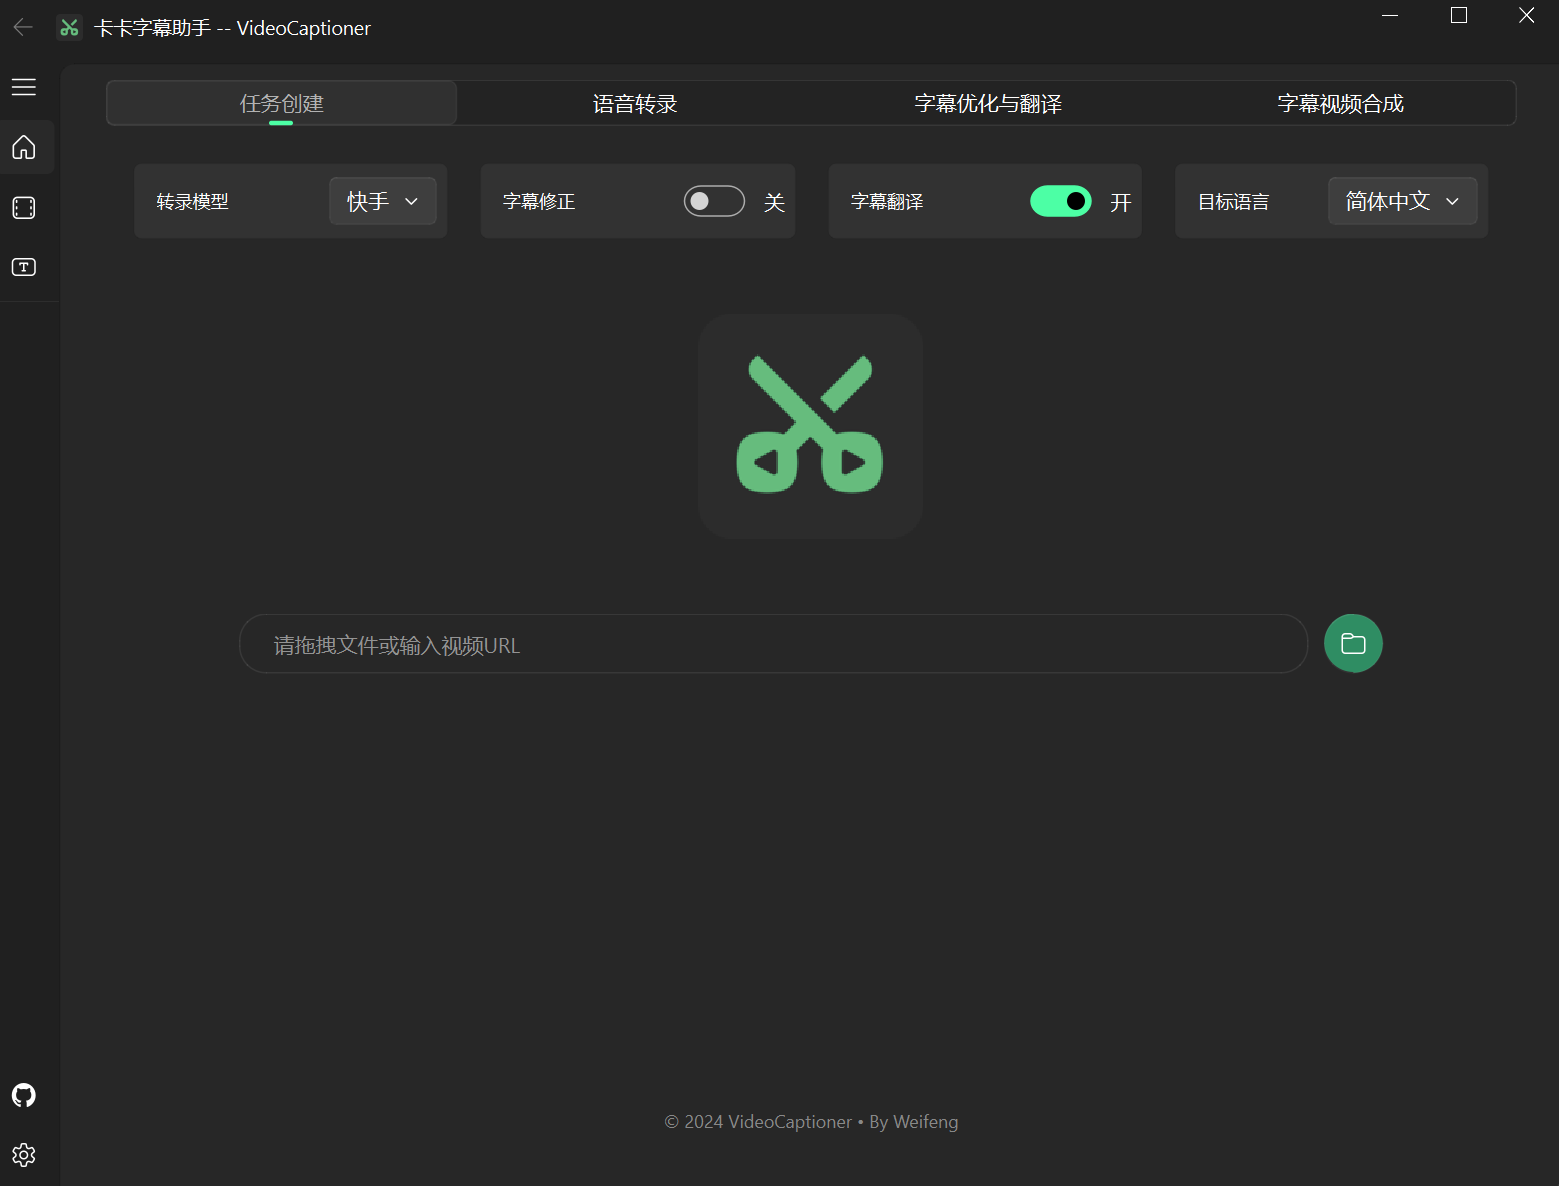
卡卡字幕助手(VideoCaptioner)是 WEIFENG2333 用 Python 写的开源字幕工具,GitHub 16,545 星、GPL-3.0 协议,把「转录、断句、翻译、压制」四步压成一条流水线:语音识别出词级时间轴,大模型按语义重新断句,需要外语就顺带翻译,最后把字幕烧进视频。有图形界面也有命令行,免费识别用必剪引擎、免费翻译用必应,不配 API Key 也能出片。
自动字幕难看,问题多半不在识别率,而在断句。按句号切的字幕一行能拖到四十个字,观众还没看完就闪了;机器翻译再按行硬翻,句意断在半截。手工修一条十分钟视频的字幕,半小时起步。VideoCaptioner 把断句和翻译交给大模型,按语义重切行、按上下文翻译,同时保留词级时间戳对齐——这一步做到位,字幕读起来跟人工差不多。
参数一览
| 项目仓库 | WEIFENG2333/VideoCaptioner,GitHub 16,545 星 |
| 协议 / 语言 | GPL-3.0,Python 3.10 以上 |
| 最新版本 | v1.4.2(2026-05-24),同时提供 pip 包 videocaptioner |
| 安装方式 | Windows 安装包(不足 60MB)、pip 安装、macOS 一键脚本 |
| 免费能力 | 必剪/剪映语音识别、必应/谷歌翻译,无需 API Key |
| 可选增强 | OpenAI 兼容接口的大模型:语义断句、上下文翻译、配音 |
核心能力
- 五个命令覆盖全流程:transcribe 转录、subtitle 优化翻译、dub 生成配音音轨、synthesize 烧字幕、process 一键跑完。
- 断句靠语义不靠标点:大模型读完整段再切行,长句拆短、短句合并,阅读节奏自然。
- 翻译带反思机制:先译一遍再自检,专有名词和上下文一致性比逐行机翻稳得多。
- 软字幕、硬字幕都支持,还能顺手把在线视频下载下来当素材,省一步导出。
- 批量并发:几个视频丢进队列一起处理,多线程跑。
上手三步
- Windows 直接下安装包双击装,首次启动自动检测环境;Mac 和 Linux 用仓库里的 run.sh,自动建虚拟环境并补上 ffmpeg。
- 先用免费通道跑一条:识别选必剪、翻译选必应,确认字幕效果。要更顺的断句再进设置填一个大模型接口,硅基流动、DeepSeek 这类都兼容。
- 命令行用户更省事:装完 pip 包后一句 videocaptioner process 视频文件就能从转录一路烧到成片,命令行参数的优先级高于配置文件和默认值。
适合谁
- 搬运、二创外语视频的账号:识别、翻译、压制一条流水线,批量出片。
- 做教程和课程的人:口播素材自动出中文字幕,省掉逐句对轴的活。
- 要给视频配多语言版本的团队:一份时间轴翻成多个语种,字幕样式统一。
问:不填 API Key 能用吗?
答:能。语音识别走必剪引擎、翻译走必应,都是免费的,装完直接处理。代价是断句优化和大模型翻译这两个最值钱的功能用不了,字幕会按识别结果原样切,长句偏多。
问:识别出现重复句子或幻觉怎么办?
答:官方 FAQ 给的办法是开 VAD 过滤静音段、换更大的模型,或者从 Large-v3 退回 Large-v2;背景音乐重的素材先做一次人声分离再识别,效果最明显。
问:字幕有水印吗?要花多少钱?
答:没有水印。软件本身免费开源,唯一成本是你自备的大模型接口,按 token 算,一条十分钟的视频做断句加翻译通常几分钱。
问:Mac 能用吗?能商用吗?
答:Mac 支持 10.15 以上,走一键脚本装环境,Intel 和 M 系列芯片都能跑。协议是 GPL-3.0,自己用、商业使用都没问题,但把改过的代码打包分发时,需要同样开源。
最后更新:2026-11-17
声明:本站所有文章,如无特殊说明或标注,均为本站原创发布。任何个人或组织,在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。
