
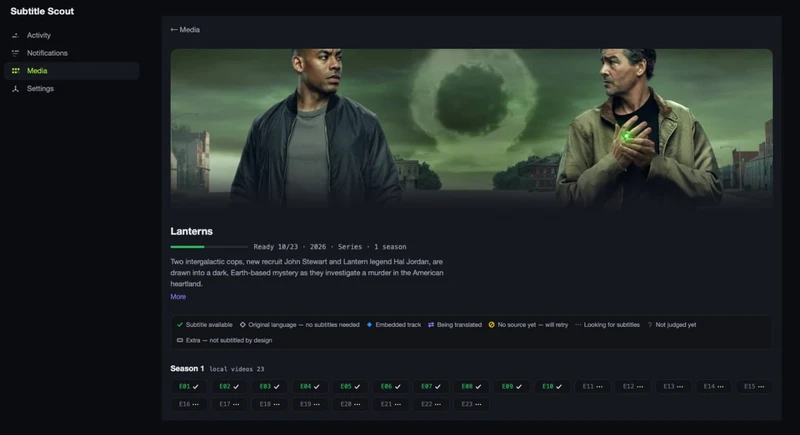
Subtitle Scout 是一个自托管的字幕自动化工具,核心是一个 LLM 判断器:它先认出你的媒体文件是哪部片子、哪一集,再去各个字幕站拉候选,逐条判断对不对得上这一集,只有匹配的才装进去;目标语言没有现成字幕时,用 AI 把别的语言逐句翻译过来。开源免费,AGPL-3.0 协议,GitHub 上 136 星。
字幕这件事的麻烦不在于找不到,而在于找到的对不上。片名有别名、剧集有分季、字幕文件的时间和版本差几秒,下十个有九个不能用。Subtitle Scout 解决的就是最后这一公里——不是把字幕丢给你,而是替你判断。
它具体做什么
- 先认片再找字幕:结合文件名、TMDB 信息和搜索结果定位到具体某一集,不是拿片名模糊搜。
- 逐条判断匹配度:从 OpenSubtitles、SubDL、ASSRT、r3sub、Jimaku、SubHD、Zimuku 等多个源拉候选,逐条评估是否属于这一集,不合适的不会自动安装。
- 没有就翻译:目标语言没有现成字幕时,调用 AI 把其他语言字幕逐句翻译成中文。
- 直接扫本地文件夹:不需要装 Plex、Jellyfin、Emby 之类的媒体服务器,指着目录就能跑。
- 自托管:跑在自己的机器或 NAS 上,字幕和媒体文件不出本地。
基本信息
| 类型 | 自托管字幕自动化系统 |
| 核心机制 | LLM 识别媒体内容,逐条判断字幕是否属于该集 |
| 字幕来源 | OpenSubtitles、SubDL、ASSRT、r3sub、Jimaku、SubHD、Zimuku 等 |
| 翻译能力 | 目标语言缺字幕时,用 AI 逐句翻译 |
| 媒体服务器依赖 | 不需要,可直接扫描本地媒体文件夹 |
| 开发语言 | TypeScript |
| 开源协议 | AGPL-3.0 |
适合谁用
- 本地存了几百部片子、字幕长期缺胳膊少腿的人
- 下载站或网盘整理党,需要批量补齐字幕
- 看冷门片、外语片,公共字幕库常常没有中文对照
- 不想为字幕单独装一套媒体服务器的人
上手怎么做
- 按项目说明部署服务(支持自托管,可跑在 Docker 或本地环境)
- 配置字幕站的访问凭据——OpenSubtitles 这类站点多数需要注册后申请 API key,项目文档里有逐个来源的申请说明
- 把媒体目录指向它,跑一次扫描,让它建立片名与剧集的识别
- 开启自动匹配,之后新下载的片子会自动走「识别 → 找候选 → 判断 → 安装」的流程
需要留意的是,它判断匹配依赖 LLM,所以你得准备一个可用的模型接口;另外字幕站本身有下载频率限制,批量跑的时候别开太猛。
问:必须装 Plex 或 Jellyfin 吗?
答:不用。它可以直接扫描本地媒体文件夹,媒体服务器只是可选的接入方式。
问:找到的字幕时间轴对不上怎么办?
答:它的判断逻辑就是在拦这类问题——不属于当前这集或版本的候选不会被安装,尽量减少下了用不了的情况。但如果源本身只有错位版本,仍需要手动调整。
问:需要自己注册字幕站账号吗?
答:多数来源需要。OpenSubtitles 这类站点要注册后申请 API 凭据,项目文档里给了每个来源的申请步骤。
问:中文能自动翻译出来吗?
答:可以。目标语言没有现成字幕时,会用 AI 把其他语言的字幕逐句翻译,翻译质量取决于你接入的模型。
问:支持 macOS 和群晖这类设备吗?
答:它是自托管服务,只要能跑 Docker 或 Node 环境就行,具体支持范围以项目文档为准。
最后更新:2026-10-26
声明:本站所有文章,如无特殊说明或标注,均为本站原创发布。任何个人或组织,在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。
